MCP vs. REST-API: Was sich ändert, wenn ein Agent direkt mit deinem CMS spricht
Bei REST schreibst du den Client. Bei MCP beschreibt sich das CMS selbst. In beiden Fällen muss die Fähigkeit darunter trotzdem existieren.
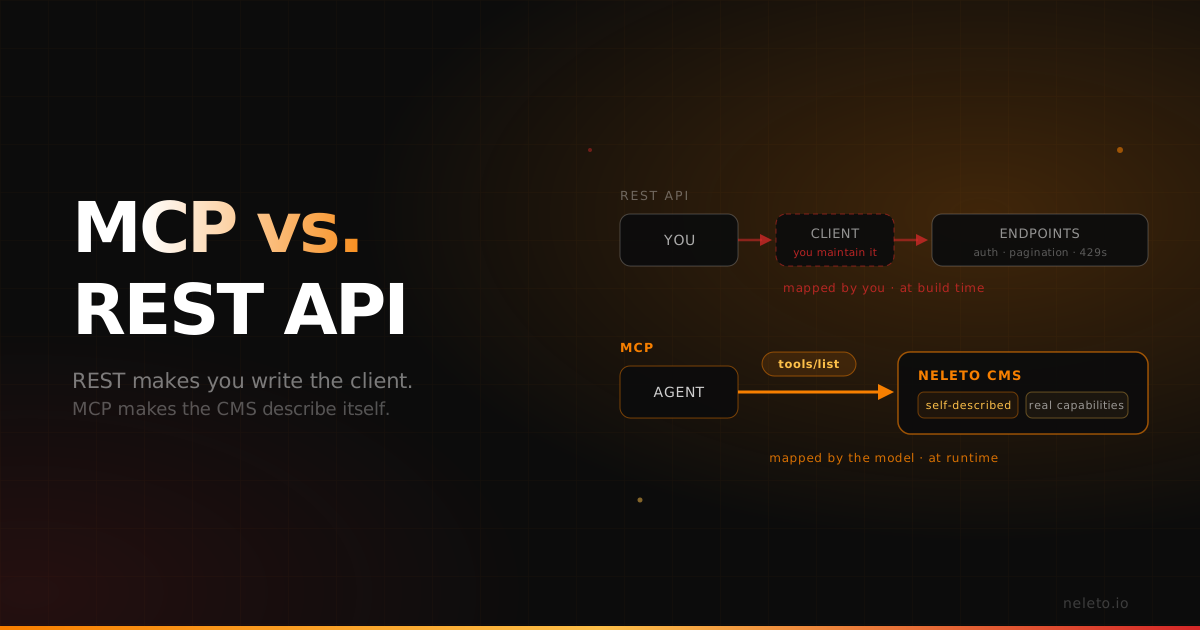
Wenn du REST gut kennst, nerven dich die meisten MCP-Erklärtexte. Entweder verkaufen sie es als magische Schicht, durch die Integration verschwindet, oder sie gehen das JSON-RPC-Format durch, ohne je zu sagen, warum dich das interessieren sollte. Zwischen den beiden ändert sich eigentlich nur eine Sache, und alles andere folgt daraus.
Was ist eine REST-API, und was ist MCP?
Eine REST-API ist eine Schnittstelle, gegen die du einen Client schreibst. Du liest die Doku, entscheidest, welche Endpoints zu deiner Absicht passen, und schreibst Code, der das eine aufs andere abbildet: Auth, Pagination, Schema, Retries und alles Weitere.
MCP (Model Context Protocol) ist ein Protokoll, mit dem ein System einem Agenten seine eigenen Fähigkeiten beschreibt. Das Modell entdeckt die verfügbaren Tools und ruft sie zur Laufzeit auf. Du schreibst also nicht für jedes einzelne eigenen Integrationscode.
Oft wird das als alter gegen neuen Weg dargestellt, und das trifft es nicht. Die eigentliche Frage ist: Wer bildet die Absicht auf Aufrufe ab, und wann? Bei REST machst du das zur Entwicklungszeit, in Code, den du danach pflegst. Bei MCP macht es das Modell zur Laufzeit, gegen eine beschriebene Tool-Oberfläche. Jeder Vorteil und jeder Kompromiss weiter unten kommt aus dieser einen Verschiebung.
Bei REST ist die Integration die Arbeit
Die Endpoints sind meistens der einfache Teil. Die Arbeit ist alles drumherum: ein Token holen und erneuern, herausfinden, welche der vierzig Endpoints du brauchst, Pagination, die sich von Collection zu Collection unterscheidet, Feldnamen auf dein eigenes Modell abbilden, entscheiden, was bei einem 429 passiert, und Tests schreiben, die anschlagen, wenn der Anbieter eine Response-Struktur ändert. Dann zieht die API-Version weiter, und der Client, den du geschrieben hast, ist jetzt das, was du pflegst: ein kleines, dauerhaftes Stück Software mit eigenem Upgrade-Pfad.
Das ist keine Kritik an REST. Es ist ein stabiler, cachebarer, nachvollziehbarer Vertrag, der zwanzig Jahre überlebt hat, weil er wirklich gut ist. Das Problem zeigt sich an genau einer Stelle: Bei einmaliger Arbeit oder kleinen Mengen ist das Verhältnis von Integrationsaufwand zur eigentlichen Aufgabe miserabel.
MCP entfernt diese Arbeit nicht, es verschiebt sie. Wer den Server baut, schreibt die Tool-Definitionen einmal (Namen, Ein- und Ausgabeschemas, Beschreibungen), und jeder Agent, der sich verbindet, bekommt diese Oberfläche.
Dieselbe Aufgabe, zwei Wege: 40 Events aus einer Tabelle
Angenommen, du musst 40 Event-Einträge aus einer Tabelle veröffentlichen, die Bilder skalieren und die Slugs aufräumen.
Als REST-Integration ist das ein Skript. Du liest die Tabelle ein, authentifizierst dich, suchst den Endpoint zum Anlegen von Events und seine Pflichtfelder, stellst fest, dass Datumswerte ein bestimmtes Format wollen, lädst jedes Bild über einen separaten Media-Endpoint hoch, verknüpfst die zurückgegebene Asset-ID mit dem Event-Datensatz, schreibst eine Slugify-Funktion, die die Regeln des CMS nachbauen soll und sie leicht verfehlt, baust Rate-Limiting ein, nachdem der zwölfte Request scheitert, und lässt das Ganze ein paar Mal gegen Staging laufen. Am Ende besitzt du ein Skript für genau diese Tabellenform.
Als Prompt gegen einen MCP-Server ist es ein Satz und ein Dateipfad, ausgeführt in Claude Code oder Cursor: „Lies events.csv, leg für jede Zeile ein Event an, skaliere die Bilder auf die Standardgrößen und mach die Slugs konsistent mit den bestehenden." Der Agent listet die verfügbaren Tools, sieht, dass es Event-Erstellung, Datei-Upload und Bildskalierung gibt, liest ein paar bestehende Events, um die Slug-Konvention abzuleiten, und legt los.
Das Kleingedruckte ist echt. Der Agent wählt vielleicht eine andere Aufrufreihenfolge als du, es kostet echte Tokens, und 40 Einträge bedeuten viele Round-Trips. Lass es gegen Staging laufen und vergleiche das Ergebnis. Und wenn daraus ein nächtlicher Job für 4.000 Zeilen wird statt einer einmaligen Aktion für 40, dann schreib doch das REST-Skript. Das ist die Entscheidungsgrenze, und sie hat sehr wenig damit zu tun, welches Protokoll moderner ist.
MCP vs. REST-API: wo welches gewinnt
| REST-API | MCP | |
|---|---|---|
| Wer bildet Absicht auf Aufrufe ab | Du, im Code, zur Build-Zeit | Das Modell, zur Laufzeit |
| Integrationsaufwand pro Nutzer | Jedes Mal ein neuer Client | Tool-Oberfläche einmal beschrieben |
| Determinismus | Exakt: gleiche Eingabe, gleiche Aufrufe | Nicht deterministisch, das Modell wählt |
| Nachvollziehbarkeit | Dein Code ist der Audit-Trail | Braucht Tool-Call-Logging zur Rekonstruktion |
| Kosten pro Lauf | Nur Rechenzeit | Rechenzeit plus Tokens pro Aufruf |
| Mehrdeutige Anweisungen | Nein | Ja, genau darum geht es |
| Am besten für | Pipelines mit hohem Volumen, strikte Verträge | Einmalige, explorative und unregelmäßige Arbeit |
| Bricht, wenn | Die API ihre Struktur ändert | Die Aufgabe Garantien braucht statt Urteilsvermögen |
Wann du stattdessen einen REST-Client schreiben solltest
Schreib den Client von Hand, wann immer du nicht hinnehmen kannst, dass ein Modell den Aufruf wählt:
- Automatisierte Pipelines mit hohem Volumen. Ein nächtlicher Sync von 10.000 Datensätzen sollte weder Token-Kosten pro Aufruf zahlen noch jede Nacht seinen Plan neu herleiten.
- Strikte Verträge. Wenn eine Aufsichtsbehörde, ein SLA oder ein nachgelagertes System davon abhängt, welche Felder genau geschrieben werden, willst du Code, den du lesen kannst, keinen Plan, den du aus Logs rekonstruierst.
- Alles, wo ein falscher Aufruf teuer ist: Massenlöschungen, Rechteänderungen, alles Unumkehrbare. Gib dem Agenten Lesezugriff und einem Menschen den Schreib-Button.
- Inhalte in ein anderes System ziehen. Ein Suchindex, eine Mobile-App oder ein statischer Build wollen eine cachebare, vorhersehbare HTTP-Antwort, kein Gespräch.
MCP ersetzt nichts davon. Es ist ein Protokoll über Fähigkeiten, die trotzdem existieren müssen: Wenn das CMS kein Bild skalieren kann, macht es auch keine Tool-Beschreibung möglich.
Nativer MCP-Server vs. ein Wrapper, den jemand um die REST-API gebaut hat
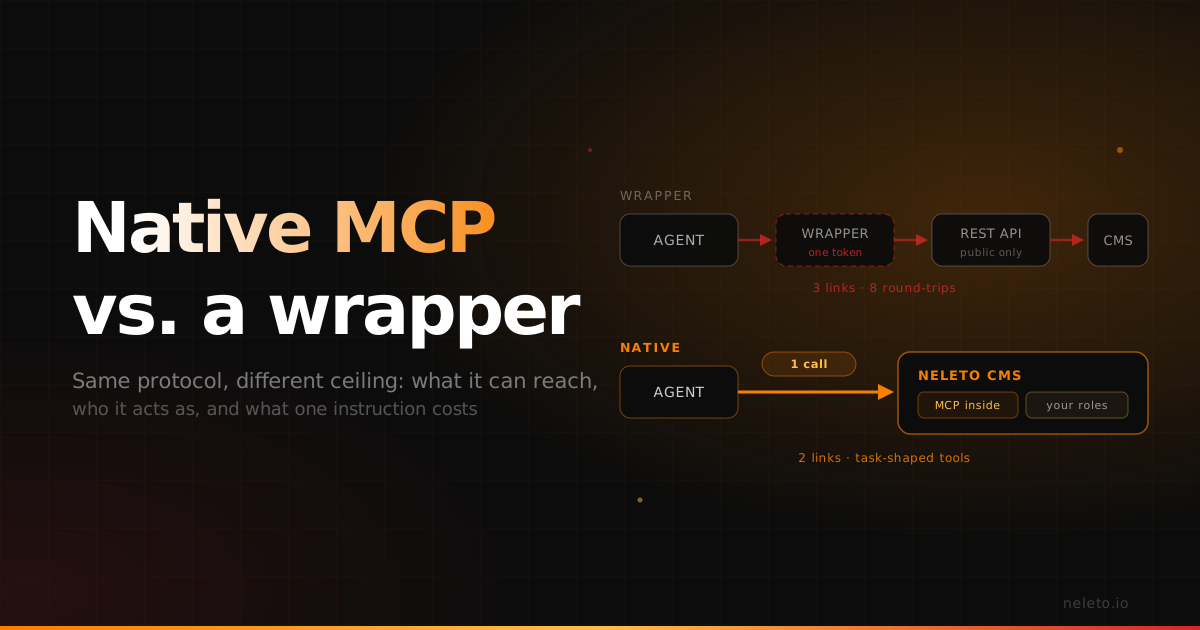
Ein nativer MCP-Server ist im System selbst implementiert. Ein Wrapper ist ein separater Prozess, der MCP-Tool-Aufrufe in REST-Requests gegen eine öffentliche API übersetzt. Beide sprechen dasselbe Protokoll, und sie verhalten sich in Produktion aus vier Gründen unterschiedlich:
- Die Abdeckung endet bei der Vorstellungskraft des Autors. Ein Wrapper stellt die Endpoints bereit, an die sein Autor gedacht hat. Alles, was nicht gewrappt ist, ist für den Agenten unsichtbar. Nicht dokumentiert-aber-schwierig, sondern unsichtbar.
- Auth ist angeschraubt. Der Wrapper hält ein API-Token und handelt als ein einziger Nutzer, also verflachen Rollenrechte meistens.
- Er hinkt hinterher. Neue Features landen erst im Produkt, dann in der API, dann im Wrapper. Die Lücke spürst du genau dann, wenn du das Neue willst.
- Er ist eine weitere Abhängigkeit: ein dritter Prozess zum Deployen, Überwachen und Aktualisieren, zwischen deinem Agenten und deinen Inhalten.
Wrapper sind wirklich nützlich. Über sie bekommen die meisten Systeme überhaupt MCP-Unterstützung, und ein guter schlägt gar keine Unterstützung. Wisse nur, welche Art du nutzt, bevor du einen Workflow darauf baust. Ausführlicher haben wir das in natives MCP vs. MCP-Wrapper durchgespielt.
Was die Spezifikation 2026 geändert hat, in einem Absatz
Die Revision vom 2026-07-28 hat MCP zustandslos gemacht. Der initialize-Handshake und der Mcp-Session-Id-Header sind weg, jeder Request trägt seine eigene Protokollversion und Client-Fähigkeiten, und ein neuer server/discover-RPC zeigt an, was ein Server unterstützt. Tool-, Prompt- und Resource-Listen sind über ttlMs und cacheScope cachebar geworden, und vom Server initiierte Requests wurden durch Multi Round-Trip Requests ersetzt: Ein Tool gibt input_required zurück, und der Client wiederholt den Aufruf mit den Antworten. Falls du dir MCP 2025 angesehen hast und das Session-Handling im Betrieb umständlich fandest, ist genau diese Beschwerde erledigt: Server können jetzt hinter einem ganz normalen Load Balancer stehen.
Wo Neleto steht
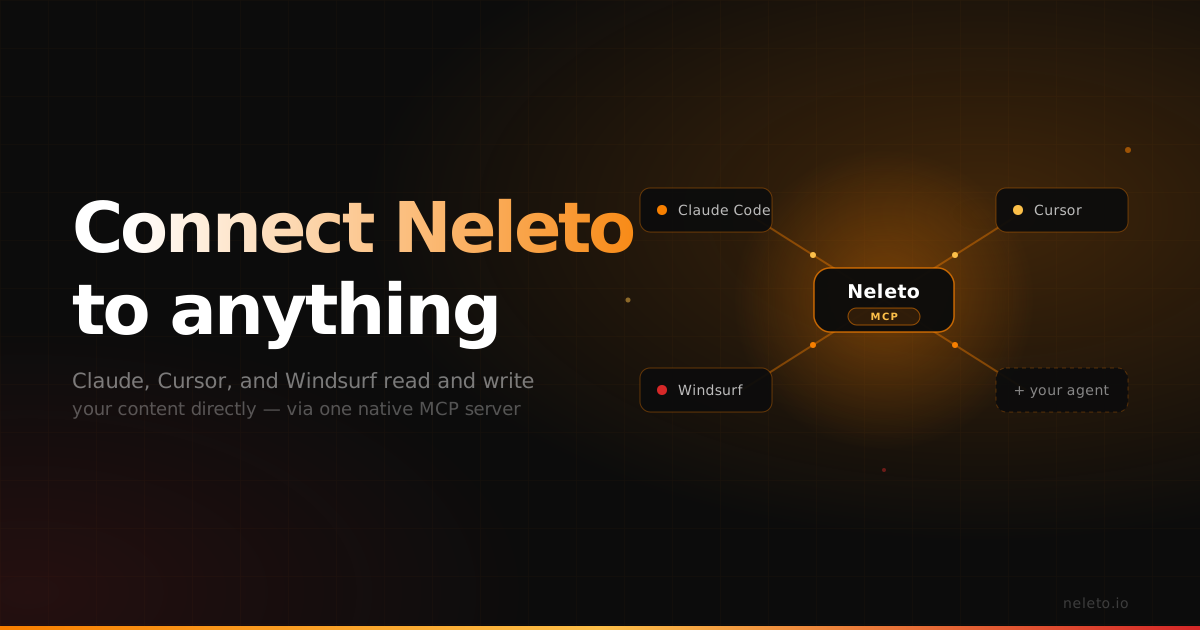
Neleto ist ein vollständiges CMS mit einem MCP-Server, der ins Produkt selbst eingebaut ist, statt eines Wrappers um die eigene REST-API. Die Tools, die ein Agent sieht, sind also die eigenen Fähigkeiten des CMS: Seiten, Blogbeiträge, Events, Dateien, Komponenten, Layouts, Bildskalierung. Der Agent handelt mit der Rolle der Person, die ihn verbunden hat, nicht mit einem geteilten Admin-Token. Er funktioniert mit Claude Code, Cursor und Windsurf.
Es gibt auch eine REST-API, um Inhalte in einen Suchindex, eine App oder ein anderes System zu ziehen, wo du eine vorhersehbare HTTP-Antwort willst und kein Modell, das irgendetwas entscheidet. Wir werden nicht so tun, als wäre der MCP-Server das richtige Werkzeug für einen nächtlichen Sync von 10.000 Datensätzen.
Andere CMS bieten auch MCP-Unterstützung, nativ und über Wrapper, und der Bereich bewegt sich schnell. Die Frage, die du jedem Anbieter stellen solltest, ist nicht, ob er MCP hat. Sondern ob es nativ ist, wie viel vom Produkt es tatsächlich abdeckt und ob es deine Rollenrechte respektiert.
Probier es selbst: Richte Claude Code oder Cursor auf eine Neleto-Instanz im Free-Plan und lass dir die verfügbaren Tools auflisten. Dieser Zehn-Minuten-Test sagt dir über jeden MCP-Server mehr als jede Vergleichstabelle.
Weiterlesen
Natives MCP vs. MCP-Wrapper: Warum der Unterschied erst in Produktion auffällt
Beide sprechen dasselbe Protokoll. Der Unterschied zeigt sich darin, was sie erreichen können, als wer sie handeln und wie viele Round-Trips eine Anweisung kostet.
Neleto mit allem verbinden: Der native MCP-Server und das Connector-Ökosystem
Dein CMS sollte keine Insel sein. So sprechen Claude, Cursor und Windsurf direkt mit deinen Inhalten — und wohin die Reise als Nächstes geht.
Statische HTML-Seite zum editierbaren CMS machen
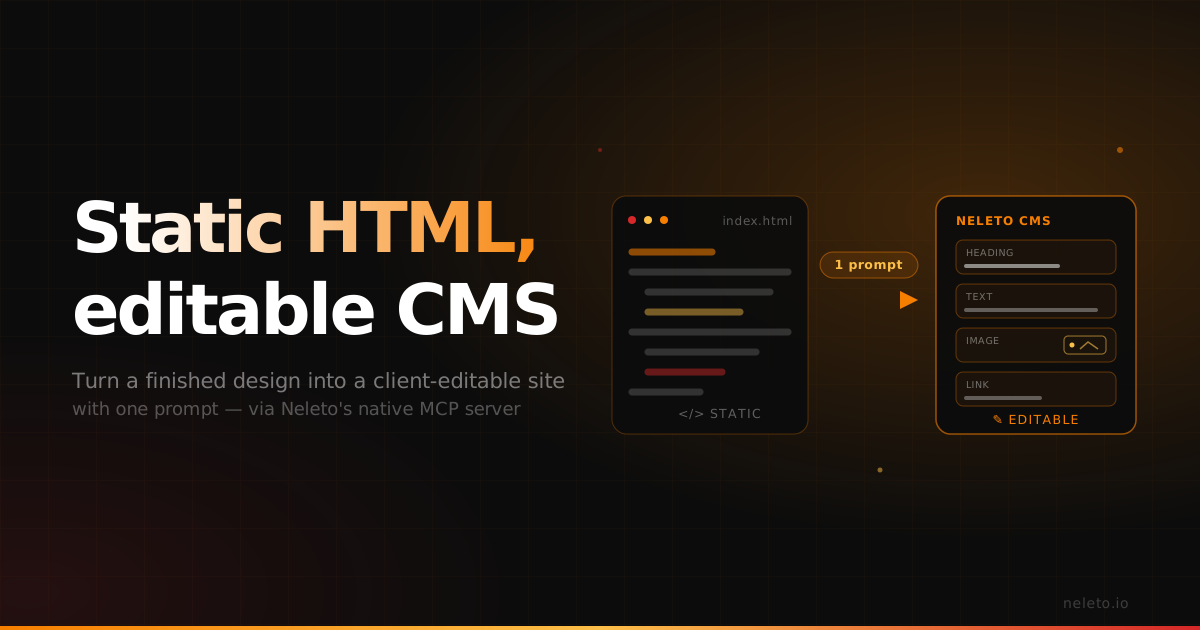
Webdesigner verlieren Tage damit, fertige Designs als CMS nachzubauen. Mit Neletos MCP-Server reicht ein Prompt, Animationen und Custom-Cursor inklusive.